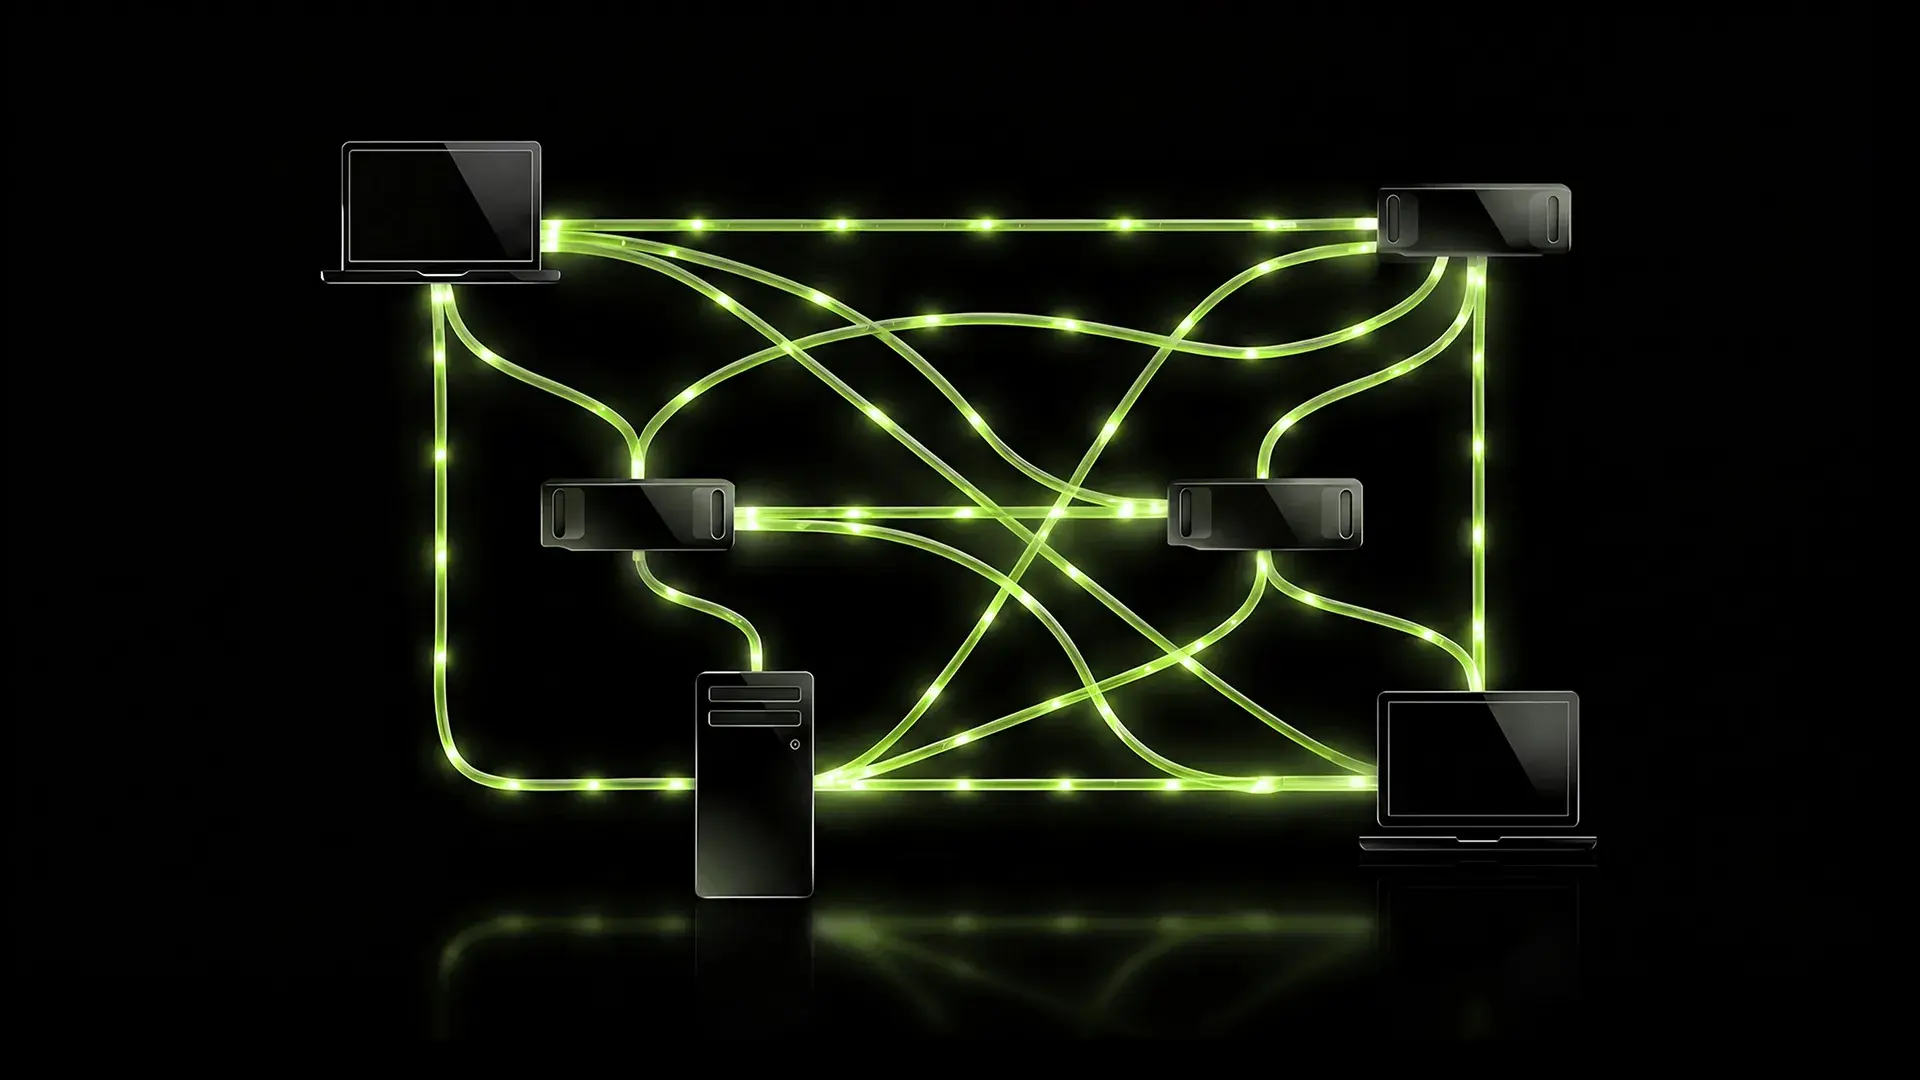
Na veletrhu IFA 2026 společnost NVIDIA představila řešení, které nově definuje lokální umělou inteligenci. Jeho cílem je Personal AI Router, zkráceně PAIR, využít stávající domácí počítače ke společnému spouštění úkolů umělé inteligence. Nejedná se o fyzický router ani nový inferenční engine, ale spíše o nástroj, který funguje jako prostředník mezi aplikacemi umělé inteligence a různými zařízeními v lokální síti.
Myšlenka je jednoduchá: pokud máte herní počítač, pracovní stanici nebo dokonce MacBook s moderním čipem, je velmi pravděpodobné, že značná část jeho výpočetního výkonu je každý den po mnoho hodin nevyužita. PAIR tato zařízení detekuje, bezpečně je propojuje a rozděluje mezi ně inferenční požadavky generované agenty umělé inteligence, čímž zajišťuje, že pracovní zátěž není zahlcena jedinou grafickou kartou.
Co přesně je NVIDIA PAIR?
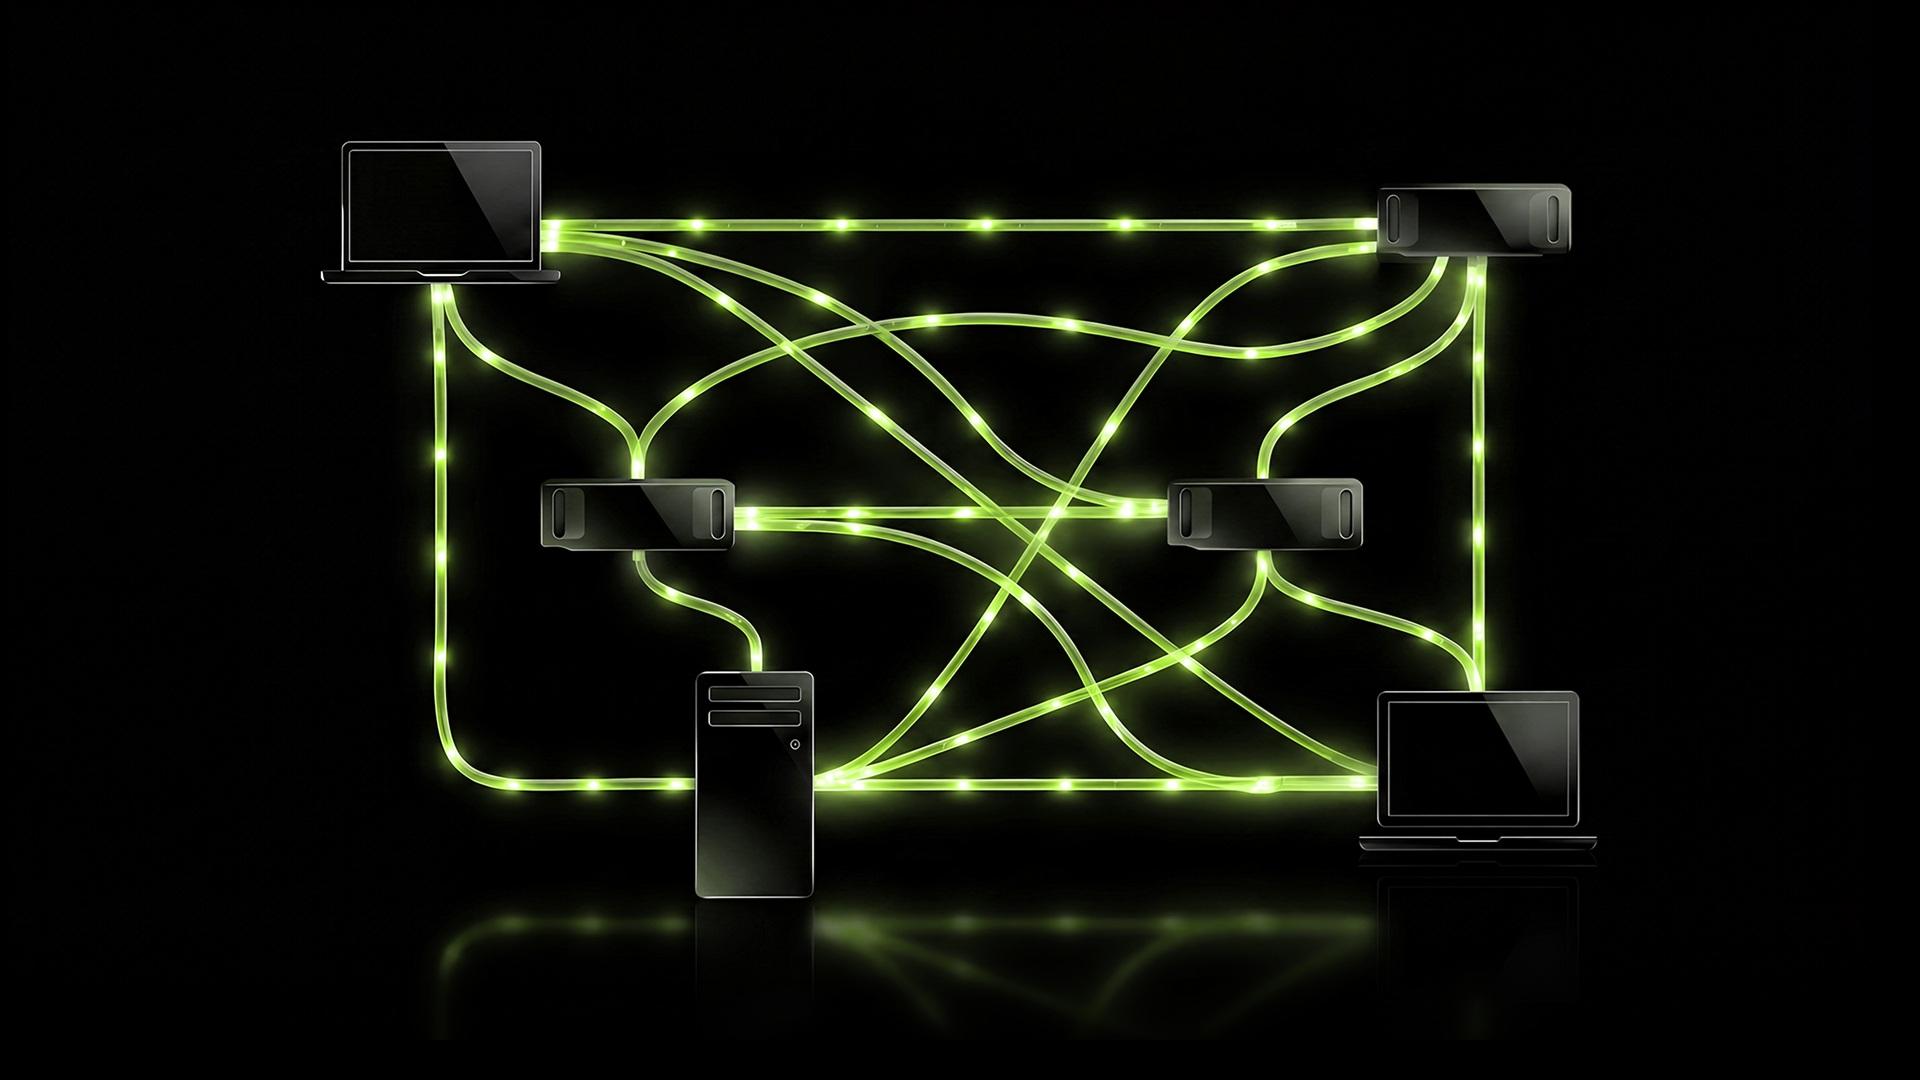
PAIR je bezplatný software s otevřeným zdrojovým kódem , který funguje jako zástupce mezi aplikacemi umělé inteligence a inferenčními enginy nainstalovanými na každém počítači. Když agent spustí více dílčích úkolů současně, PAIR rozhodne, který počítač v síti zvládne každý z nich, s přihlédnutím k tomu, zda má načten požadovaný model, k aktuálnímu zatížení GPU a k tomu, zda je počítač dostupný. Pro uživatele je proces bezproblémový: vidí pouze jedno připojení, zatímco v zákulisí je provoz rozdělen mezi zúčastněné uzly.
Jednou z jeho klíčových vlastností je, že nenahrazuje Ollamu ani LM Studio , ale spíše je využívá. PAIR ve skutečnosti přebírá kontrolu nad porty, které tyto enginy standardně používají k přijímání požadavků, a přeposílá je na nejvhodnější uzel. To znamená, že stávající aplikace mohou nadále fungovat beze změn, což výrazně snižuje vstupní bariéru pro ty, kteří již mají své prostředí umělé inteligence nastavené lokálně.
Jak funguje rozdělení úkolů
Vyhledávání zařízení se provádí pomocí mDNS, což je stejný protokol, který používá tiskárna k zobrazení v síti . Po instalaci každé zařízení oznámí svou dostupnost a ostatní jej automaticky detekují. Uzel můžete také přidat přímo pomocí jeho IP adresy, ale obvyklý postup je tak, že hlavní zařízení zobrazí šestimístný PIN kód, který musí druhé zařízení zadat pro navázání párování.
Po připojení je komunikace mezi uzly šifrována pomocí mTLS, což znamená vzájemné certifikáty, které zaručují, že provoz neopustí privátní síť . To je důležité pro ty, kteří pracují s citlivými informacemi, protože instrukce a data agentů zůstávají uchovávány v místní síti, aniž by procházely externím serverem. Vývojáři projektu však varují, že před použitím ve sdílených nebo nedůvěryhodných sítích by mělo být zkontrolováno zabezpečení sítě LAN , protože otevírá lokální koncové body HTTP a umožňuje vyhledávání v síti LAN.
Představení a demonstrace
Otázkou za milion dolarů je, zda to skutečně zlepšuje výkon. NVIDIA sdílela neoficiální demo s agentem Hermes Desktop a Ollamou s modelem Qwen 3.6 35B A3B. Úloha s pěti subagenty, která trvala v průměru 18 minut na jednom notebooku s RTX Spark, byla dokončena za 8 minut a 48 sekund s použitím clusteru tří strojů : notebooku, DGX Spark a RTX 5090. Toto zlepšení o něco více než 2x je vysvětleno skutečností, že dílčí úlohy lze provádět paralelně na více GPU, místo aby se řadily do fronty na jedné.
Společnost zdůrazňuje, že se nejedná ani o obecný benchmark, ani o slib lineárního škálování . Výsledek silně závisí na typu pracovní zátěže, použitém modelu, konfiguraci sítě a na tom, které uzly jsou k dispozici. Vysoce sekvenční úlohy nebo ty, kde má požadovaný model pouze jeden počítač, budou mít jen malý přínos. PAIR navíc nesdružuje paměť různých grafických karet, takže není řešením pro načítání modelu, který se nevejde na jednu GPU.
Kompatibilita a požadavky
Beta verze PAIR je k dispozici pro Windows 11, Linux a macOS s podporou architektur x64 a arm64 (ačkoli Windows na ARM je považován za experimentální). Hardwarové požadavky zahrnují grafické karty GeForce RTX řady 20 nebo novější, RTX PRO nebo novější s procesorem Turing, DGX Spark nebo Apple M4 nebo novější. Vyžaduje se také alespoň 8 GB RAM a 20 GB místa na disku a pro provoz není potřeba připojení k internetu, pouze pro stažení šablon.
Zajímavým detailem je, že PAIR není omezen pouze na produkty NVIDIA ; může se ho zúčastnit jakýkoli počítač, na kterém je spuštěn Ollama nebo LM Studio, včetně systémů s platformou Apple Silicon. Ve skutečnosti byl úspěšně testován v sítích s až 18 GPU. Dalším z jeho určujících rysů je flexibilita uzlů připojovat se a odpojovat dle libosti – například když notebook přejde do režimu spánku nebo počítač začne hrát hru –, protože plánovač přizpůsobuje distribuci v reálném čase.
RTX Spark a další nové funkce
PAIR přichází v době, kdy NVIDIA také finalizuje uvedení prvních počítačů s RTX Spark, které je plánováno na říjen. Tyto stroje kombinují grafickou kartu Blackwell s 20jádrovým procesorem Grace a až 128 GB unifikované paměti a jsou navrženy pro lokální spouštění agentů umělé inteligence. Na veletrhu IFA představily své produkty Lenovo (Yoga Pro 9n a Yoga 9n) a Acer (koncept kompaktního stolního počítače) a očekává se, že své modely představí i společnosti Dell, HP, ASUS, MSI a Microsoft.
Spolu s PAIR oznámila společnost NVIDIA zjednodušení pro další projekty agentů. Perplexity Portable Computer bude podporovat grafické karty RTX s alespoň 24 GB VRAM v systémech Windows i Linux, což uživatelům umožní spouštět kompletní pracovní postupy bez utrácení kreditů a s předchozím povolením k odesílání dat do cloudu. Hermes Agent bude obsahovat nastavení jedním kliknutím, které automaticky detekuje grafickou kartu, a OpenClaw bude mít podobnou možnost ve Windows.
Co se týče výkonu, optimalizace v souboru llama.cpp umožňují až 1,9x vyšší propustnost na grafické kartě GeForce RTX 5090 , zatímco vLLM zlepšuje propustnost 1,2x na grafické kartě Blackwell RTX PRO 6000 a až 1,4x na clusterech dvou karet DGX Spark. Tato vylepšení jsou již k dispozici prostřednictvím LM Studio, Ollama a samotných enginů.
To vše ukazuje na jasný trend: přesun většiny práce s umělou inteligencí z cloudu a využití hardwaru, který již máme doma. PAIR je dalším dílkem skládačky a ačkoli je v beta verzi, stojí za to ho vyzkoušet, pokud máte více než jeden výkonný počítač. Finální verze zatím nemá datum vydání, ale komunita si ji již může stáhnout a přispět vylepšeními prostřednictvím GitHubu.